Jev 如何让 Agent 记住重要的上下文:20 个项目的上下文压缩与记忆实践#
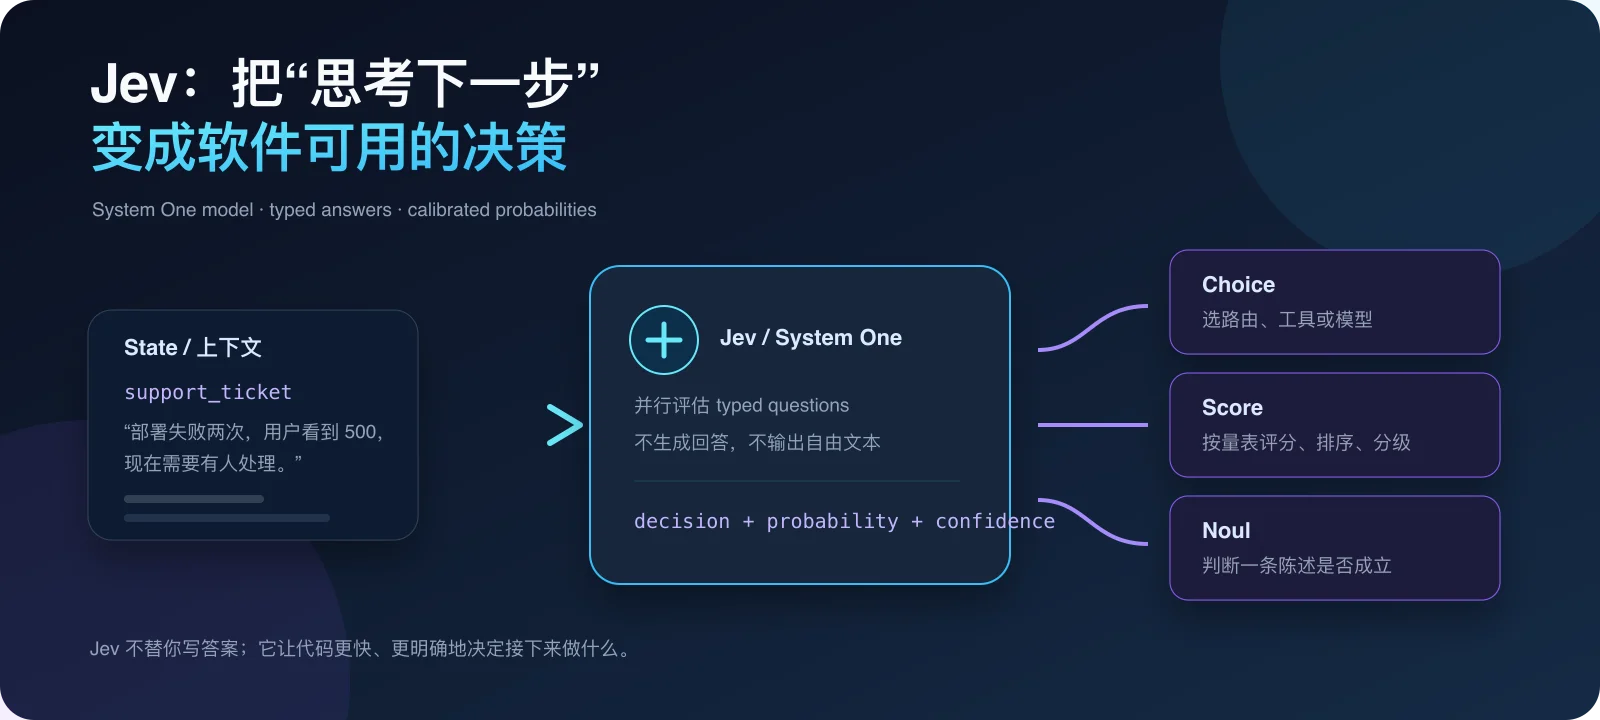
上一篇介绍了 Jev 的基本接口:把开放式模型输出前移成 Choice、Score 和 Noul 等类型化判断,让代码直接得到可以进入分支的结果。
这次把问题推进一步:当 Agent 的对话、工具调用和检索结果越来越长时,Jev 能不能帮助它“记住重要的,忘掉暂时不重要的”?
答案是可以,但这里的“记忆”需要先拆开。Awesome Jev 的“上下文与记忆”目录目前收录 20 个项目。它们大多不是在做一个传统意义上的长期向量记忆库,而是在做一层更靠近 Agent runtime 的工作:判断哪些信息应该进入下一次模型请求,哪些信息可以隐藏、截短、归档或交给更强的模型处理。
本文按 2026 年 9 月 20 日目录快照整理。目录页面说明,项目描述和性能数据主要来自仓库说明,本站没有对每个项目做独立运行复测;因此文中的“项目实现了”指源码或说明中可核对的接入方式,不等同于效果保证。
先给结论:Jev 更像上下文的交通警察,不是记忆数据库#
一个长任务 Agent 至少有四种不同的“记忆”:
| 记忆层 | 解决的问题 | 典型实现 |
|---|---|---|
| 当前上下文 | 这一轮模型现在需要看到什么 | 消息、工具调用、检索片段 |
| 会话状态 | 中断后从哪里继续 | checkpoint、会话树、JSONL |
| 工作记忆 | 当前任务已经确认了哪些事实 | 文件、结构化 state、任务摘要 |
| 长期记忆 | 跨任务还能复用什么 | Store、数据库、用户画像、知识库 |
这 20 个项目的共同点主要发生在第一层和第二层之间:它们不负责永久保存所有知识,而是对即将发给主模型的上下文做选择。
完整会话 / 工具历史 / 检索候选
              │
              ▼
       Jev:逐项做结构化判断
       keep / hide / truncate / escalate
              │
              ▼
    确定性代码组装下一次模型请求
              │
              ├─ 主模型看到精简上下文
              └─ 原文留在会话文件或归档中
这条边界很重要:Jev 判断“这条记录是否与当前任务相关”,本地代码决定“怎样修改上下文”。模型不应该直接改写历史、获得文件权限或决定不可逆删除。
1. 20 个项目可以分成五条路线#
1.1 历史压缩:只把有用的工具记录送进模型#
这是目录中最集中的一组,也是与 Agent 上下文最直接的一组。
| 项目 | 宿主 Agent | Jev 参与的位置 |
|---|---|---|
fast-jev-compaction | Claude Code | 分别判断工具调用和完整结果是否保留;本地执行保留、截短或删除 |
jev-pruner | Claude Code | Bash 结果进入主模型前按块筛掉冗余文本 |
Winnow | Claude Code | 逐块判断 Read、Bash、Grep 输出;无关块隐藏但可恢复 |
yoshi | Claude Code / Codex | 在代理转发层给历史条目打分,过滤已经失效的中间试错输出 |
omp-jev-compaction | Oh My Pi | 判断工具调用和结果的保留价值,记录删减决定 |
fast-dev-compaction | Codex | 会话触达上限时逐条评估历史消息和工具调用,尽量只剪掉噪音 |
这里有一个值得注意的设计:fast-jev-compaction、pi-fast-jev-compaction 和 pi-jev-compaction 都把“工具调用”和“工具结果”分开看。调用本身可能仍然需要保留,因为它解释了 Agent 做过什么;完整结果却可能已经过时,或者只需要保留一个截短版本。
这比“把最早的 N 条消息删掉”更接近任务语义,也比“把整个历史重写成摘要”更容易保留路径、命令、错误码和代码片段等原文证据。
但它并不意味着无损。fast-jev-compaction 的项目说明明确提醒,自动删减可能误删上下文;jev-context 也提醒,返回文本节省的 token 不等于整项任务或账单一定节省。上下文压缩必须有回退和可恢复路径。
1.2 Pi 生态:把过滤接到原生压缩之前#
Pi 相关的项目最多,说明 Pi 的扩展点很适合实验这种“在 runtime 里重排上下文”的策略:
pi-fast-jev-compaction:清理过时工具历史,原文保留;如果释放空间仍然不够,再交给 Pi 原生摘要。pi-jev-context:对旧消息做相关性判断,低分片段从后续请求中隐藏,需要时可以关闭筛选恢复完整上下文。pi-jev-compaction:以完整工具调用与返回为单位决定是否保留,保留近期消息边界和原文证据。pi-jev-compact:默认筛除旧工具历史,也允许把助手文字纳入候选,删减范围可配置并保留判断记录。fast-jev-compaction-pi:把任务目标、用户和助手文本、工具名称与参数、结果长度和错误标记交给 Jev,但不把工具输出正文交给 Jev;本地代码再决定完整保留、截短或删除。
这一组项目共同指向一个实用的两级压缩策略:
第一层:Jev 过滤明显过时或不相关的记录
        ↓ 仍然太长?
第二层:Pi 原生摘要 / 主模型压缩
第一层保留原文,第二层才承担“重新表达”。当任务依赖精确的文件路径、命令参数或报错内容时,这个顺序通常比一开始就让模型总结更稳妥。
1.3 检索和 Skill 门控:减少“还没开始就塞满”的上下文#
上下文治理不只发生在历史已经很长之后,也可以发生在 Agent 刚启动时。
jev-context把 ripgrep 找到的代码候选交给 Jev 判断相关性,只把判为相关的片段返回给 Codex,并记录过滤前后的载荷。它解决的是“搜索结果太多”,而不是“会话太长”。
jev-skill-gate则把判断对象换成 Skill:结合项目技术栈、目录和 README,判断哪些 Skill 说明与当前项目相关,减少默认加载的说明;其余 Skill 仍保留手动调用入口。
这两个项目提示了一个更一般的原则:
上下文窗口的优化,优先从“不要把不相关的东西放进来”开始,再考虑“怎样压缩已经放进来的东西”。
同一原则也能用于工具 schema、MCP 能力说明、插件文档和 RAG 候选。Jev 不是只用来删历史,它也可以用来决定“这一轮哪些能力值得出现”。
1.4 会话交接与递归上下文:让压缩结果可以被解释#
codex-jev-compaction面向 Codex 的任务交接上下文,用 Jev 筛选旧的只读工具记录,并生成包含来源、筛选理由和原文次序的交接包。
azdaja走的是更实验性的 RLM 路线:完整资料保存在本地求值器中,只把选定的源码窗口交给 Jev 做类型化语义判断,再由递归语言模型决定继续检查、合并还是探索。
更偏基础设施的 jev-use把这类判断抽成可复用的封装:同一个 state 上的多个 noul、choice、score 问题可以批量提交,再由 toVerdict() 按原语处理答案和置信度;不适合交给 Jev 的写作、开放式问题、过大输入或不确定情况,通过类型化 escalation 契约退回主 LLM。它更像一组“决策边界工具”,而不是某个特定宿主的压缩插件。
它们的共同价值不是“删得更多”,而是让删减过程成为可解释的中间产物:
- 哪些记录被候选过?
- Jev 针对什么问题做了判断?
- 采用了哪个阈值和问题版本?
- 被隐藏的原文在哪里?
- 这次交接能否在需要时重放?
如果上下文压缩要用于生产 Agent,这些问题比一个漂亮的 token reduction 数字更重要。
1.5 浏览器、信息流和日志:同一模式的相邻应用#
目录还收录了一些不属于典型编码 Agent 的项目,它们仍然揭示了“上下文选择”的同一结构:
bluenoise先用本地规则过滤 X/Twitter 帖子与回复,未命中时再让 Jev 判断是否隐藏。elons-job对 X 详情页回复做本地规则、缓存和并发保护,再用 Jev 判断色情、性暗示和引流内容;隐藏内容可恢复。your-signal让 Jev 按个人偏好给信息流评分,再决定高亮、折叠或隐藏。jevlogs在 OpenTelemetry 日志进入进一步分析前判断诊断价值、优先级和路由信号,并保留归档路径。
这些项目不一定应该被直接称为“Agent memory”,但它们展示了同一个运行时模式:先用便宜、可逆的规则缩小候选,再用 Jev 做受限判断,最后由本地策略决定展示、路由或升级。
2. 这些项目共同采用的架构#
把目录里的实现抽象一下,通常可以得到五步:
1. 收集候选:消息、工具调用、结果、代码片段或 Skill
2. 定义问题:是否保留调用?是否保留完整结果?是否相关?
3. Jev 判断:Choice / Score / Noul + 概率或置信度
4. 本地执行:keep / hide / truncate / archive / escalate
5. 记录证据:原文、问题版本、判断、阈值、最终动作
其中第三步的输入应该尽量小。一个项目不一定需要把整段工具输出发给 Jev;fast-jev-compaction-pi 的做法就是只给任务和结构元数据,让 Jev 判断“这条调用或结果是否值得保留”,把具体截短和删除留给本地代码。
一个概念性的实现可以写成这样:
type HistoryItem = {
  call: { name: string; args: unknown };
  result: { text: string; isError: boolean };
};

const decisions = await jev.judge({
  state: {
    task: currentTask,
    recentMessages,
    candidates: history.map((item) => ({
      tool: item.call.name,
      args: item.call.args,
      resultLength: item.result.text.length,
      isError: item.result.isError,
    })),
  },
  questions: {
    keepCall: { type: "noul", instructions: "后续推理是否需要知道这次调用发生过?" },
    keepFullResult: { type: "noul", instructions: "后续推理是否需要完整的原始结果?" },
  },
});

const nextContext = history.flatMap((item, index) => {
  const decision = decisions[index];
  if (decision.keepCall < 0.2) return [];
  if (decision.keepFullResult >= 0.8) return [item];
  return [truncateResult(item)];
});
这段代码的关键不在具体 SDK,而在责任分工:Jev 输出结构化判断,flatMap 和 truncateResult 是确定性的,本地归档仍保留完整 item。真实系统还应该加入最小保留规则,例如最近的用户消息、最近一轮工具调用、错误结果、当前文件变更和人工确认记录不能只凭一个概率被删掉。
3. “记忆”不是越多越好:保留对象要分层#
从这些项目可以抽出一个比“上下文压缩”更细的保留策略:
| 对象 | 默认策略 | 原因 |
|---|---|---|
| 用户目标与约束 | 始终保留 | 它定义了相关性的参照系 |
| 最近的模型与工具边界 | 保留 | 维持协议结构和当前因果链 |
| 工具调用名称与参数 | 倾向保留 | 解释 Agent 做过什么 |
| 成功的长输出 | 相关时保留,否则截短 | 可能只是中间产物 |
| 错误、失败尝试与修复结果 | 谨慎保留 | 错误本身可能是后续决策的证据 |
| 已归档的原文 | 不进入每轮上下文 | 需要时可恢复和回放 |
| 无关检索候选 | 过滤 | 从源头减少噪音 |
这也是为什么项目目录里反复出现“保留原文”“可恢复”“记录判断”“不另写摘要”等表述。对编码 Agent 来说,README.md 中的一行路径、一次失败的命令和一个编译器错误,可能比一段流畅但丢失细节的总结更有价值。
4. Jev 做不到什么#
4.1 Jev 不是长期记忆存储#
它可以判断某条信息是否与当前任务相关,但不会自动替你解决 namespace、用户隔离、数据过期、冲突合并和隐私删除。长期记忆仍然需要 Store、数据库或文件系统,以及明确的写入与读取策略。
4.2 高置信度不等于事实正确#
0.95 表示模型对一个受限问题的判断信心,不表示原始内容是真的,也不表示可以跳过权限检查。删除文件、发送消息、写入数据库等副作用仍应由 allowlist、身份、审批和审计系统控制。
4.3 压缩可能造成“静默失忆”#
最危险的失败不是请求报错,而是 Agent 看起来继续工作,却已经看不到关键证据。因此至少需要:
- 保留完整原文或可恢复的归档。
- 记录每次筛选的理由、概率、阈值和问题版本。
- 低置信度时保守保留,或升级到主 LLM / 人工。
- Jev API 超时、解析失败时 fail-open,回退到原上下文或宿主 Agent 的原生压缩。
- 用真实任务回放评估“省了多少 token”和“丢了多少关键事实”这两个指标。
5. 如果要在自己的 Agent 里开始尝试#
我建议按下面的顺序做,而不是一开始就改写整个会话系统:
- 先选一个低风险对象,例如 RAG 候选、搜索结果或旧的成功工具输出。
- 只问一个原子问题:“这条记录是否与当前任务相关?”
- 先做 shadow mode:Jev 只记录建议,不改变真正发给模型的上下文。
- 用人工或任务最终结果检查 false positive 和 false negative。
- 再启用可逆隐藏,保留一键恢复和完整原文。
- 最后再把策略扩展到工具调用、Skill、会话交接和自动摘要前置过滤。
一个足够小的评估集应该同时包含:
- 需要精确路径、参数和错误原文的编码任务;
- 需要回看早期决策的多轮任务;
- 早期工具结果已经过时的任务;
- 相关性模糊、应该升级而不是自动删除的边界任务。
不要只看上下文 token 数。至少同时记录任务成功率、恢复次数、关键事实遗漏、首 token 延迟、Jev 调用成本和回退比例。
总结:让 Agent 记忆更可靠,关键是“选择性进入上下文”#
Awesome Jev 的这 20 个项目给出的共同信号是:Agent 记忆的第一步,不一定是建立更大的记忆库,而是减少每一次模型请求里无关、重复和已经失效的内容。
Jev 在这里最适合扮演一个小而清晰的角色:
上下文候选 → 类型化相关性判断 → 可逆的本地策略 → 主模型它可以帮助 Agent 在 Claude Code、Codex、Pi 等宿主里筛选工具历史,也可以帮助代码搜索、Skill 加载、日志路由和会话交接缩小输入范围。但完整记忆仍然由宿主的会话文件、归档、Store 和权限系统负责。
换句话说,可靠的 Agent 不是“什么都记住”,也不是“把旧内容全部摘要掉”,而是知道:
哪些事实必须始终可见,哪些内容可以暂时隐藏,哪些原文必须留在身后,并且在需要时能够解释和恢复。
参考资料
- Awesome Jev:上下文与记忆项目目录 —— 本文的项目清单与分类入口。
- Jev:fast-jev-compaction —— Claude Code 工具调用与结果压缩。
- Jev:yoshi —— Claude Code / Codex 上下文剪枝代理。
- Jev:pi-fast-jev-compaction —— Pi 的可恢复工具历史压缩。
- Jev:jev-use ——
judge()、toVerdict()与类型化 escalation 的通用封装。 - Jev:jev-context —— Codex 代码搜索结果的相关性过滤。
- Jev:jev-skill-gate —— 按项目相关性门控 Skill 说明。
- TypeSafe AI:Introducing System One Models & Jev —— Jev 的 System One 定位与基础 primitives。
- 上一篇:Jev 是什么:从“让模型写答案”到“让软件做决定” —— Jev API、LangChain 集成与工具门控。